指南
关于 AI From U API 的实用指南:base URL 怎么填,哪些 SDK 不用改就能跑,五个模型该怎么选,以及一次请求最后是怎么变成套餐里扣掉的那几笔积分的。每一篇都是从我们自己运营这套接口的经验里写出来的,能跑的代码和能逐笔核对的算法都写在正文里,不写没有用处的空话。
-
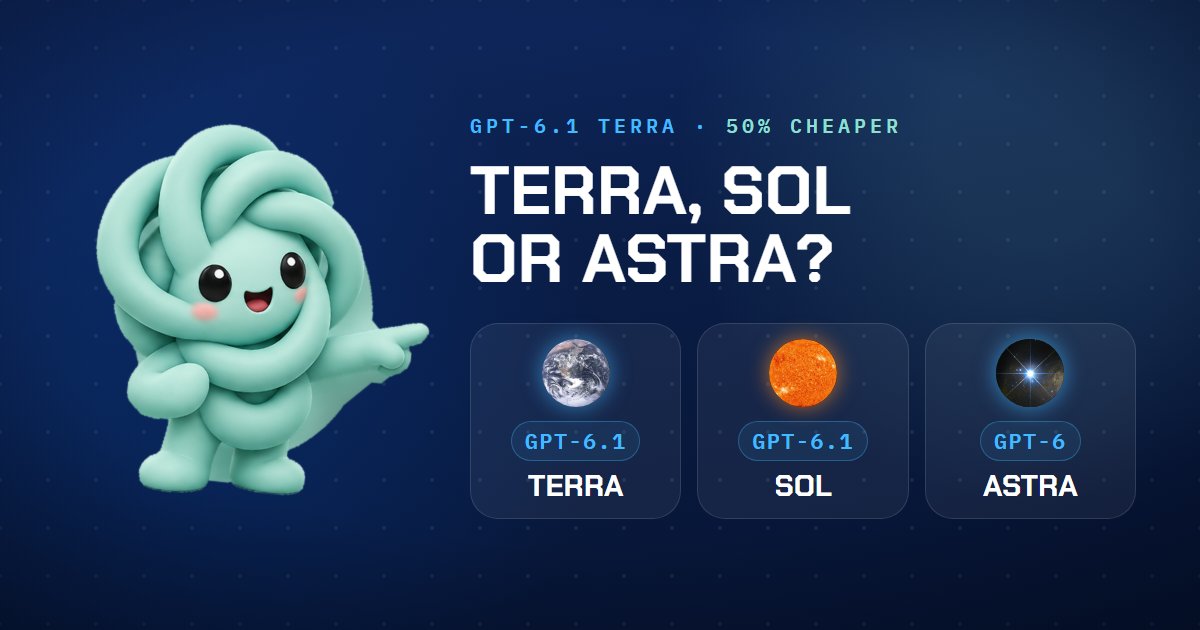
GPT-6.1 Terra is here: which model should you use?
GPT-6.1 Terra costs half what Sol does. What Terra, Sol and Astra each cost, where each wins on OpenAI's own benchmarks, and which one to pick for each task.
-
在 astra、sol、terra 和 luna 之间怎么选
五个模型、一个端点、一份预算,要定的不是哪个最强,而是每一类请求该走哪一个。日常产品活先用 terra,推理深度确实值回票价时把那一类提到 sol,答错代价高过 token 的活才动用 astra,后台的分类打标摘要交给 luna。长上下文不加价,混用只是请求里的一个字段,每一笔都能在控制台逐条核对。
-
在 Cursor 里用自己的 base URL
Cursor 说的就是 OpenAI API,所以它也能对这里说。这篇讲的是模型设置里要填的两个地方、要加进去的五个模型名字,以及在相信编辑器之前先用一条命令把 key 和 base URL 都验一遍的做法。写下来的是那两个值,因为菜单会随版本挪动,而值不会。五个名字直接写就行,OpenAI 那套写法也认。
-
在兼容 OpenAI 的 API 上跑 LangChain
ChatOpenAI 只要改 base_url 和 api_key 两个字段就能连上这里。invoke、stream、工具调用和结构化输出全都原样通过,因为网关提供的就是 OpenAI 的 wire format。文章还讲了五个模型怎么选,以及缓存读取按输入费率一半计费如何让 agent 的循环一直便宜。
-
把 OpenAI SDK 指向新的 base URL
把已有的 OpenAI SDK 应用接到这里只需要改两处:base URL 和 key。/v1/chat/completions 和 /v1/responses 都在服务,流式输出和工具调用原样透传;五个模型可以直接写,OpenAI 风格的模型名会按重量级读成对应的那一档,改不动的 model 一行照样能跑。
-
流式响应与 100 秒的边缘超时
为什么一个不用流式的长请求会在边缘等到约 100 秒就被切断,为什么把 stream 设成 true 就能避免,流式请求的用量是怎么在最后一帧里回来的,以及计量系统在流式请求前后做了什么:什么时候预留、按什么价格结算、中途断线时那笔预留会怎么处理。这些都能在控制台的三个计时上对上:上传、首 token、总耗时。
-
按 token 类别计费:一次讲清楚
为什么输入、缓存读取、缓存写入和输出要分开计量,每个模型在每一类 token 上分别按多少积分计费,缓存读取为什么只按所属模型输入费率的一半算,以及一次真实请求从 token 数到最终积分的完整算法。这里写的是我们自己的计费方式,不是别人的价目表,每一档费率都能拿你自己的账单逐笔核对。