OpenAI互換APIを運用して分かったことの記録
AI APIプラットフォームを運用しながら分かったことを書いています。一つのリクエストがどう課金されるのか、計測が何を記録しているのか、そして料金表には書かれていない部分について。
-
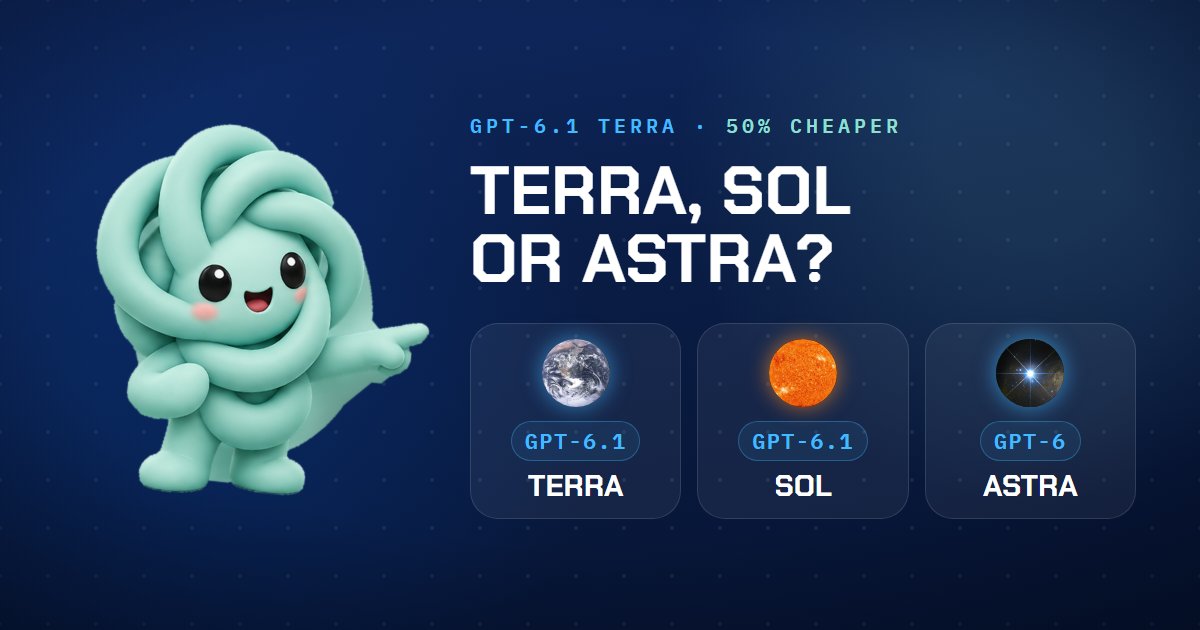
GPT-6.1 Terra is here: which model should you use?
GPT-6.1 Terra costs half what Sol does. What Terra, Sol and Astra each cost, where each wins on OpenAI's own benchmarks, and which one to pick for each task.
-
astra、sol、terra、lunaの選び分け
五つのモデル、一つのエンドポイント、一つの予算。決めるのはどれが強いかではなく、どの種類のリクエストをどれに回すかです。日常の製品仕事はまず terra、推論の深さが効くところだけ sol、間違いの代償がトークンより高い仕事に astra、裏で回る分類や要約は luna。長い文脈でも単価は変わりません。
-
Cursorを自分のbase URLで使う
CursorはOpenAI APIを話すので、このゲートウェイとも話せます。モデル設定で埋める二か所、追加する五つのモデル名、そしてエディタを信用する前にkeyとbase URLの両方を確かめるコマンドを一つ。メニューは版ごとに動くので、書き残すのは手順ではなく値のほうです。OpenAI流の名前も通ります。
-
OpenAI互換APIでLangChainを動かす
ChatOpenAIにbase_urlとapi_keyの二つを渡すだけでこのエンドポイントにつながります。invokeもstreamもツール呼び出しも構造化出力もそのまま通る理由、五つのモデルの選び方、そしてキャッシュ読み取りが入力の半分で課金されエージェントのループを安く保つ仕組みまで。
-
OpenAI SDKのbase URLを差し替える
すでにOpenAI SDKで動いているアプリをここへ向けるには、base URLとキーの二か所を変えるだけです。/v1/chat/completionsと/v1/responsesの両方を提供し、ストリーミングもツール呼び出しもそのまま通ります。五つのモデルは直接使え、既存のモデル名も重量級として読みます。
-
ストリーミングとエッジの100秒
ストリーミングしない長いリクエストが、なぜ約100秒でエッジに切られるのか。stream を true にするだけで何が変わるのか。ストリームの最後のフレームが運ぶ使用量で計量がどう精算されるのか、途中で接続が切れたらそれがどうなるのか。ポータルの三つの時計(アップロード、最初のトークンまで、合計)の読み方まで。
-
トークン種別ごとの課金の仕組み
入力、キャッシュ読み取り、キャッシュ書き込み、出力をなぜ別々に計測するのか、各モデルが種別ごとに何クレジットを課金するのか、キャッシュ読み取りが入力単価の半分で済む理由、そして実際のリクエストを最後の一クレジットまで計算した例をまとめています。自分の請求書と突き合わせられる計算です。